00a
Tartalomjegyzék és tananyagterv
Ez a fájl — a teljes sorozat térképe.
ElőfeltételNincs — ezzel kezdj.
00a. lecke
"AI az alapoktól" — a teljes lecke-sorozat térképe.
Ez a fájl nem tanít új dolgot — hanem megmutatja, mi hol van, mi milyen sorrendben érdemes, és mi mihez kell előfeltételként. Ha valaha elveszel a fájlok között, ezt a fájlt nyisd meg elsőnek.
Használat: ez a fájl futtatható — lefuttatva szépen kiírja a teljes tananyagtervet a terminálba/konzolba, kereshető formában.
A 00b egy gyors, gyakorlati áttekintés a legfontosabb fogalmakról — vektor, mátrix, valószínűség —, hogy el tudj indulni. A 14c ugyanezekre épít, de sokkal mélyebben: a derivált teljes levezetését adja, miután már láttad, mire kell a gradient descenthez. A második olvasás mindig többet ad, ha közben már használtad a fogalmat.
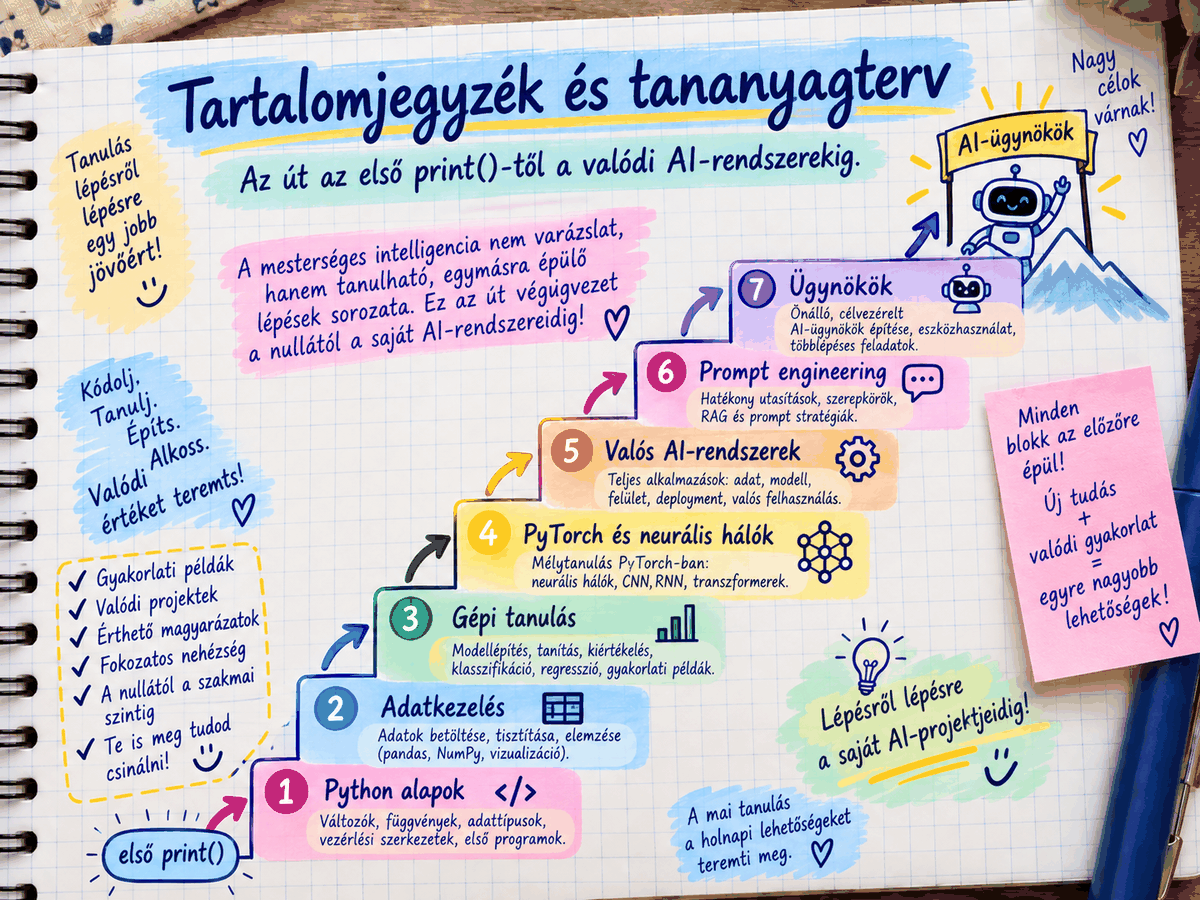
Ez a fájl — a teljes sorozat térképe.
Vektorok, mátrixok, valószínűség, átlag/szórás, gradiens — gyakorlati jelentéssel.
Programozási alapok, adatkezelés, az első egyszerű gépi tanulási modellek.
Hogyan 'tanul' egy modell — az alapötlet, kód nélkül/egyszerű kóddal.
Mélyebb magyarázat a tanulási folyamatra, plusz az AI 'kereteinek' korlátaira.
A PyTorch alapjai — tenzorok, automatikus deriválás.
Az első valódi neurális háló felépítése és tanítása PyTorch-csal.
A legfontosabb ML-algoritmusok áttekintése, mikor melyiket használjuk.
Teljes matematikai levezetés: mi a derivált, hogyan jön ki, miért kell a gradient descent-hez.
Teljes munkafolyamat: adat -> tisztítás -> tenzor -> modell -> tanítás -> kiértékelés.
Hogyan tanulnak/működnek a valós ipari AI-rendszerek.
Tokenizálás, embedding, Transformer/attention, előtanítás, finomhangolás.
Mi kell fizikailag egy AI-rendszer működtetéséhez.
Teljes történeti áttekintés, nevekkel, dátumokkal, kísérletekkel.
Train/val/test split, cross-validation, regularizáció (dropout, L1/L2, early stopping).
CrossEntropyLoss, softmax, argmax — nem csak szám-jóslás, hanem kategorizálás.
Normalizálás, standardizálás, one-hot encoding, adatbővítés.
Hogyan használj már betanított modellt kevés saját adattal.
Confusion matrix, precision/recall/F1, ROC-AUC.
API-csomagolás, verziókezelés, monitorozás, model drift.
Few-shot, chain-of-thought, system prompt — a Transformer-mechanizmusra alapozva.
GDPR, EU AI Act kockázati kategóriák, büntetések, gyakorlati checklist.
Nagy szereplők, üzleti modellek, API-árazás, saját modell vs. API költségbecslés.
Eszközhasználat, ReAct-ciklus, védelmi rétegek; MCP, A2A, mérések, kockázatok és szabályozás 2026-ban.
Fogalmak, előrejelzések, az irányítás problémája, a mai modellek viselkedése, álláspontok és kormányzás.
Qubit, hibajavítás, hardververseny, kvantumelőny, ütemtervek, titkosítás és a kvantum–AI kapcsolat.
Munka, deepfake, magánszféra, gyerekek, biztonság, energia — és a valódi hasznok, közvélemény, szabályozás, gyakorlati teendők.
Hogyan keres az AI a saját dokumentumaidban: darabolás, embedding, vektoros keresés, mini-RAG NumPy-jal.
Multimodális modellek, diffúzió (zajból kép), felhasználás, korlátok, jog és hitelesség.
Gyakorlati projekt: API-hívás, előzmények, költség, RAG, biztonság, tesztelés.
Asszisztens választása, jó munkafolyamatok, promptrecept, ellenőrzés, adatvédelem.
Minden korábbi lecke tudását összefűző, komplett gyakorlati feladat.
Az összes bevezetett szakkifejezés ábécérendben, magyar+angol néven.
A sorozat hat nagy blokkra oszlik:
A) alapozás (00a, 00b, 1-13. lecke) — Python, NumPy, Pandas, scikit-learn, PyTorch alapok, matematikai háttér
B) gépi tanulás magja (12b, 14, 14b, 14c, 15. lecke) — hogyan tanul egy modell, neurális háló, deriválás, első projekt
C) valós világ és nyelvi modellek (16-19. lecke) — hogyan működnek a valós AI-rendszerek, hogyan épül fel egy ChatGPT-szerű modell, adatközpontok, AI-történelem
D) profi szint / kiegészítő mélység (20-28. lecke) — megbízható modellépítés, MLOps, prompt engineering, jog, gazdaság
E) a jövő és a társadalom (29-32. lecke) — AI-ügynökök és 2026-os helyzetük, szuperintelligencia, kvantumszámítógépek, az AI aggályai és reményei
F) gyakorlati AI (33-36. lecke) — RAG és vektoradatbázisok, képgeneráló modellek, saját chatbot API-val, mindennapi AI-használat
Ezek után jön a záróprojekt (37. lecke), ami az összes blokkot egyben használja.
Az E) blokk (ügynökök, szuperintelligencia, kvantumszámítógépek, aggályok) azért jön a technikai rész után, mert a benne tárgyalt fogalmakhoz — például a Transformer vagy a finomhangolás — már kellenek a korábbi leckék. Így nem csak elméletben, hanem a mögöttes technika ismeretében lehet végiggondolni ezeket a kérdéseket.
Formátum: [lecke száma] cím -> Miről szól (1 mondat) -> Előfeltétel: mely leckéket érdemes előtte ismerni
Ha nem emlékszel, hol tartottál, ez a javasolt sorrend:
00a -> 00b -> 1-11 -> 12 -> 12b -> 13 -> 14 -> 14b -> 14c -> 15 -> 16 -> 17 -> 18 -> 19 -> 20 -> 21 -> 22 -> 23 -> 24 -> 25 -> 26 -> 27 -> 28 -> 29 -> 30 -> 31 -> 32 -> 33 -> 34 -> 35 -> 36 -> 37 -> 38 (bármikor, referenciaként)
Nem feltétlenül — a "előfeltétel" oszlop azt mutatja, mi segít megérteni az adott leckét, de ha pl. csak a 27-28. lecke (jog/ gazdaság) érdekel, azokat önmagukban is el lehet olvasni — a sorozat úgy lett megírva, hogy minden lecke hivatkozik vissza a korábbiakra ("emlékeztető a X. leckére"), szóval ha valami nem világos, a hivatkozott lecke megadja a hiányzó alapot.
1. Futtasd a keres() függvényt saját kulcsszóval (pl. "modell", "adat", "hálózat") — nézd meg, melyik leckék jönnek elő.
2. Nézd végig a tananyagtervet, és jelöld meg (papíron vagy kommentben), melyik leckéket olvastad már el, és melyiket nem — ez segít látni, hol tartasz a teljes ívben.
3. Ha a GitHub repódba (pl. ai-tanulas) feltöltöd ezt a fájlt, érdemes a repó főoldalán (readme.md) is hivatkozni rá, hogy bárki, aki megnyitja a repót, elsőként ezt lássa.
A tananyagterv itt már áttekinthető útvonalként jelenik meg.