14. lecke
Egyszerű neurális háló építése PyTorch-csal
Ebben a leckében mindazt, amit eddig tanultál, egy valódi, tanuló neurális hálóvá rakod össze. Megnézzük, milyen problémát nem tudott megoldani a 12. lecke egyenes vonalú modellje, felépítjük a hálót az nn.Module segítségével, megírjuk a tanítási ciklust, amelyben a modell ténylegesen tanul, végül előrejelzést készítünk a betanított hálóval.
- A probléma, amit a 12. lecke modellje nem tudott megoldani
- A neurális háló felépítése — nn.Module
- A modell létrehozása és kipróbálása (még tanítás nélkül)
- Tanító adatok — visszatérünk az autós példához
- A tanítási ciklus — itt történik a "tanulás"
- Előrejelzés a betanított modellel
- Olvasási idő: kb. 10 perc (a kódok kipróbálásával több)
- 6 rész · 11 kódpélda
- Előfeltétel: pip install torch
- A végén gyakorló feladatok ellenőrzik a tudásodat
Előfeltétel: pip install torch
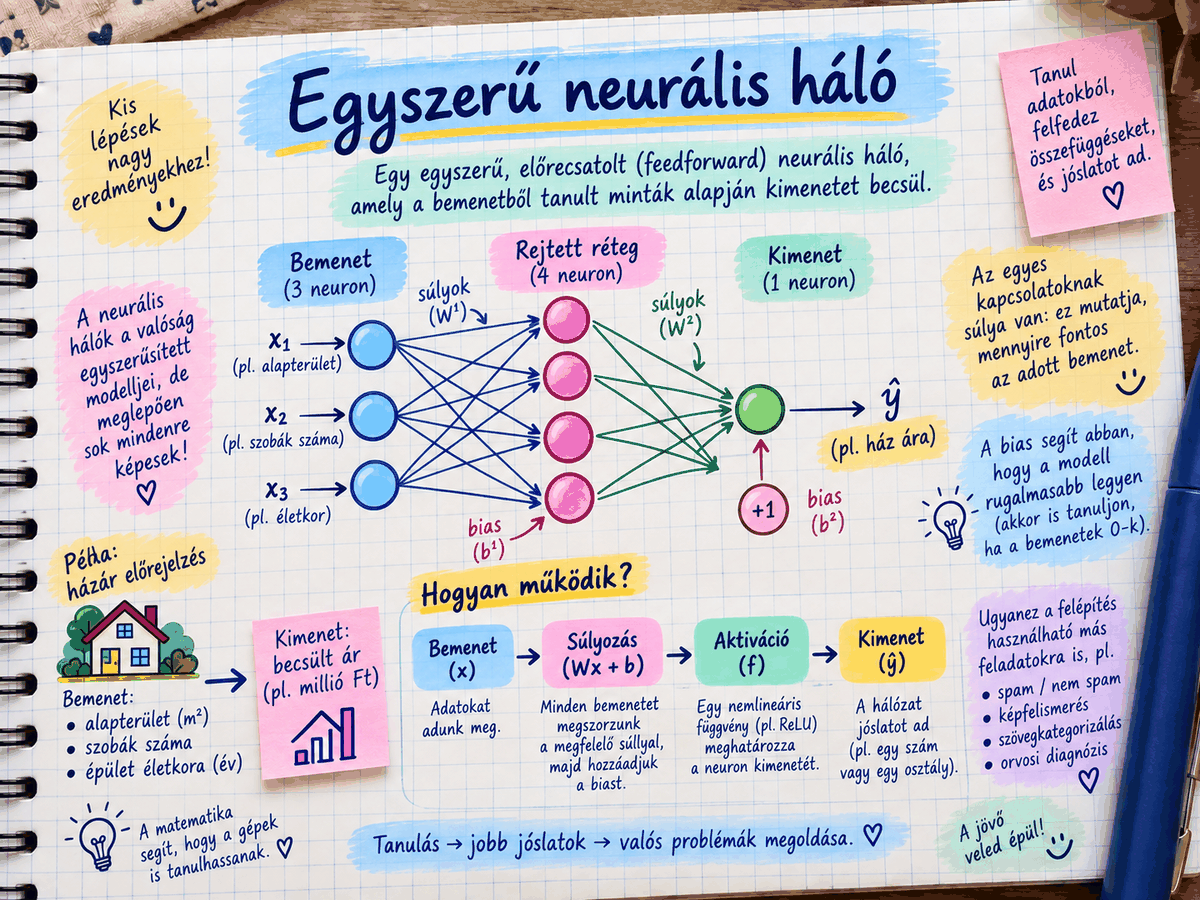
Mi ez valójában? Mi az a neurális háló, ha lehántjuk róla a rejtélyt? A neurális háló nem más, mint egymás után kapcsolt lineáris regressziók (emlékezz a 12. leckére!), közéjük ékelt egyszerű, nemlineáris "kapcsolókkal" (aktivációs függvényekkel). Ha a 12. leckében egy egyenest illesztettünk az adatokra, itt több egyenest kapcsolunk össze, rétegenként, hogy összetettebb, görbülő mintázatokat is fel tudjon ismerni a modell — amiket egyetlen egyenes nem tudna leírni.
import torch
import torch.nn as nn
1. A probléma, amit a 12. lecke modellje nem tudott megoldani
Miért nem elég a 12. lecke lineáris regressziója mindenre? A 12. leckében az autó-ár becslésünk egy egyenes vonalat illesztett — ez tökéletes, ha az adatokban valóban egyenes vonalú (lineáris) az összefüggés. De a valóságban rengeteg összefüggés nem egyenes, hanem görbe, hullámzó, vagy bonyolultabb mintázatú (pl. képfelismerésnél a "macska" és "kutya" közötti különbség nem írható le egyetlen egyenessel). A neurális háló erre a problémára válasz: több egyszerű "egyenes-illesztést" kapcsol össze, közéjük "görbítő" elemekkel, így összetett, görbe mintázatokat is meg tud tanulni.
2. A neurális háló felépítése — nn.Module
class EgyszeruHalo(nn.Module):
    def __init__(self):
        super().__init__()
        self.reteg1 = nn.Linear(1, 8)   # 1 bemenet -> 8 "rejtett" érték
        self.aktivacio = nn.ReLU()      # nemlineáris "kapcsoló"
self.reteg2 = nn.Linear(8, 1) # 8 rejtett érték -> 1 kimenet def forward(self, x):
x = self.reteg1(x)
x = self.aktivacio(x)
x = self.reteg2(x)
return xEz a PyTorch standard "sablonja" egy neurális háló megépítésére — bontsuk szét lépésről lépésre
- "class EgyszeruHalo(nn.Module):" — ez azt mondja: "ez az én modellem, ami a PyTorch beépített nn.Module 'sablonjából' örökli a szükséges alap-képességeket" (emlékezz, ez hasonló ahhoz, amikor a 6-11. leckékben a listák/DataFrame-ek "saját metódusairól" beszéltünk — itt magad hozol létre egy ilyen "saját képességekkel rendelkező" dolgot).
- "__init__" — ez a rész akkor fut le, amikor létrehozod a modellt (EgyszeruHalo()) — itt definiálod, milyen rétegek lesznek a hálóban. Az nn.Linear(1, 8) egy lineáris regressziós réteg (pontosan olyan, mint a 12. leckében!), csak itt nem 1, hanem 8 külön "egyenest" illeszt párhuzamosan, 1 bemenetből 8 "rejtett" kimenetet számolva.
Nem feltétlenül — egy túl nagy háló (túl sok rejtett neuron) kevés tanító adat mellett könnyen "bemagolhatja" a példákat ahelyett, hogy általános mintázatot tanulna; ezt hívják "túltanulásnak" (overfitting). A megfelelő méret megtalálása kísérletezés kérdése, akárcsak a tanulási rátáé.
- "forward(self, x)" — ez a függvény mondja meg, mi történik, amikor egy adatot "átküldesz" a hálón: először átmegy a reteg1-en (8 párhuzamos egyenes), utána az aktivacio-n (a "görbítő" lépés, lásd lentebb), végül a reteg2-n (ami a 8 rejtett értéket vissza-tömöríti 1 végső kimenetté). Ez pontosan az az "adatfolyam", amiről korábban (7. lecke, függvények) tanultunk — csak itt több rétegen keresztül folyik az adat.
Miért kell a 'nemlineáris kapcsoló' (aktiváció), mit csinál pontosan a ReLU? Ez a legfontosabb rész, amiért a neurális háló többet tud, mint a 12. lecke sima lineáris regressziója! Ha csak egyeneseket (nn.Linear) kapcsolnál egymás után, aktiváció nélkül, a matematika úgy alakulna, hogy több egymás utáni egyenes összessége önmaga is csak egy egyenes maradna — tehát hiába raknál 100 réteget egymás után, a végeredmény ugyanolyan "egyenes vonalú" maradna, mint a 12. leckében.
A ReLU (Rectified Linear Unit) egy nagyon egyszerű szabály: "ha az érték pozitív, hagyd változatlanul; ha negatív, cseréld 0-ra." Ez a látszólag apró "törés" az, ami lehetővé teszi, hogy a háló görbe, töréspontokkal teli mintázatokat tanuljon meg — mert minden egyes "kapcsoló" a saját pontján "bekapcsol" vagy "kikapcsol", és a sok apró kapcsoló együttes hatása már egy bonyolult, görbülő függvényt tud közelíteni, még akkor is, ha minden egyes összetevője (az nn.Linear rétegek) csak egyszerű, egyenes vonalú matematikát végez.
Nem — a ReLU a legelterjedtebb, de léteznek más aktivációs függvények is (pl. Sigmoid, Tanh, vagy a nagy nyelvi modelleknél gyakran használt GELU). Mindegyik ugyanazt a célt szolgálja: nemlinearitást visz a hálóba, csak kicsit másképp "görbítenek".
3. A modell létrehozása és kipróbálása (még tanítás nélkül)
model = EgyszeruHalo()
teszt_bemenet = torch.tensor([[5.0]])
kimenet = model(teszt_bemenet)
print("Kimenet tanítás előtt:", kimenet)Amikor létrehozod a model = EgyszeruHalo()-t, a PyTorch minden egyes réteg "meredekségét és kezdőpontját" (emlékezz a 12b leckére!) véletlenszerű, kezdő értékekkel tölti fel — ez olyan, mintha a 12. lecke autós modellje egy totálisan véletlenszerű egyenessel indulna, mielőtt még egyetlen adatot is "látott" volna. A kimenet ezért jelenleg értelmetlen — a "tanítás" (lásd lentebb) az, ami ezeket a véletlen kezdő értékeket fokozatosan, értelmes értékekké formálja.
4. Tanító adatok — visszatérünk az autós példához
X = torch.tensor([[10.0], [30.0], [60.0], [90.0], [120.0], [150.0]])   # km (ezerben)
y = torch.tensor([[8.5], [7.2], [5.8], [4.5], [3.2], [2.1]])           # ár (millióban)
Miért ilyen furcsa alakúak a tenzorok — miért [[10.0], [30.0], ...] és nem csak [10.0, 30.0, ...]? Emlékezz a 10-11. leckében tanult mátrix-fogalomra: a PyTorch (és minden neurális háló könyvtár) elvárja, hogy az adatok "táblázat-szerűen" legyenek megadva — minden sor egy-egy adatpont (itt: egy autó), minden oszlop egy-egy tulajdonság (itt csak 1 oszlop van: a km). Ez a kettős szögletes zárójel ezt a "táblázat" formát adja — 6 sor, 1 oszlop — szemben egy sima, "lapos" listával, ami csak 6 elem lenne, tulajdonság-struktúra nélkül. A modellünk (nn.Linear(1, 8)) kifejezetten ezt a táblázat-formátumot várja bemenetként.
5. A tanítási ciklus — itt történik a "tanulás"
hibafuggveny = nn.MSELoss()
optimalizalo = torch.optim.SGD(model.parameters(), lr=0.0001)
for korszak in range(1000):
    joslat = model(X)                     # 1. előrejelzés a JELENLEGI tudással
hiba = hibafuggveny(joslat, y) # 2. mennyire téved? optimalizalo.zero_grad() # 3. "nullázzuk" az előző kör számításait
hiba.backward() # 4. kiszámoljuk, MERRE kell módosítani
optimalizalo.step() # 5. TÉNYLEGESEN módosítjuk a paramétereket if korszak % 100 == 0:
print(f"Korszak {korszak}, hiba: {hiba.item():.4f}")Emlékezz a 12b leckére, ahol az autós modellünk a "hőmérő-hasonlattal" tanult: "próbáljunk egy kicsit más beállítást, nézzük meg jobb-e, ha igen, menjünk arra tovább" — és a 13. leckére, ahol megismerted a requires_grad/.backward() mechanizmust, ami ezt a "próbálgatást" matematikai deriválással automatizálja. Ez az 5 sor pontosan ez a mechanizmus, csak "iparosított", újrahasználható formában:
1. joslat = model(X) — a modell (a jelenlegi, még tökéletlen tudásával) megbecsüli az árakat. Ez megfelel a 12. lecke model.predict()-jének.
2. hiba = hibafuggveny(joslat, y) — összeveti a becslést a valós árakkal, és egyetlen számba sűríti, mennyire téved a modell (az mseloss, "Mean Squared error loss" — átlagos négyzetes hiba — pontosan azt a "négyzetre emelt eltérés" számítást végzi, amit a 12b leckében kézzel is kiszámoltunk).
- optimalizalo.zero_grad() — ez egy fontos, könnyen elfelejtett technikai lépés: a PyTorch alapértelmezés szerint "halmozza" a gradienseket (a .grad értékeket a 13. leckéből) minden .backward() hívásnál, ahelyett hogy felülírná őket — ez bizonyos esetekben hasznos, de itt nem azt akarjuk, hogy az előző kör számításai "összeadódjanak" a mostanival. A zero_grad() "törli a táblát", hogy minden körben frissen, tisztán számolhassunk.
4. hiba.backward() — ez a 13. leckéből ismert automatikus deriválás, csak most nem 1-2, hanem a modell összes paraméterére (mindkét réteg minden "meredekségére és kezdőpontjára") egyszerre kiszámolja: "ha ezt a paramétert egy icipicit megváltoztatnám, mennyit nőne vagy csökkenne a hiba?"
5. optimalizalo.step() — ez a lépés az, ami ténylegesen módosítja a paramétereket, a backward() által kiszámolt irányba, egy kicsi lépéssel (ennek mértékét az "lr", learning rate, "tanulási ráta" szabályozza — lásd lentebb). Ez felel meg a 12b lecke "hőmérő- hasonlatának" "menjünk arra tovább" lépésének.
Ezt az 5 lépést ismételjük 1000-szer (a "korszak" ciklus ezt számolja) — minden egyes körben egy icipicit javul a modell, pontosan úgy, ahogy a 12b lecke "sötét szoba, melegebb/hidegebb" hasonlatában leírtuk, csak most ezt a PyTorch végzi el, matematikailag pontosan, emberi szemmel követhetetlen sebességgel.
Mi az az 'lr=0.0001' (learning rate), miért pont ez a szám? A "tanulási ráta" azt szabályozza, mekkora lépéseket tegyen a modell egy-egy körben a "jobb irány" felé. Ez egy kényes egyensúly: ha túl nagy a lépés, a modell "túllövi" a célt, és soha nem stabilizálódik (mint amikor egy hőszabályzó túl agresszíven reagál, és állandóan túlfűt, majd túlhűt); ha túl kicsi, a modell túl lassan tanul, és 1000 kör sem lenne elég. A 0.0001 itt egy tapasztalati érték — a gyakorlatban ez a szám az egyik fontos "csavar", amit egy AI-fejlesztőnek kísérletezve kell megtalálnia az adott feladathoz.
Igen — a gyakorlatban ritkán használnak csak sima SGD-t fix tanulási rátával. Egy népszerű, "okosabb" optimalizáló például az Adam, ami menet közben, automatikusan hangolja a lépésméretet, így kevesebb kézi próbálgatással is stabilabban tanul a modell.
6. Előrejelzés a betanított modellel
uj_auto = torch.tensor([[75.0]])
becsult_ar = model(uj_auto)
print("Becsült ár 75 000 km-nél:", becsult_ar.item())A model(uj_auto) eredménye még mindig egy tenzor (emlékezz a 13. leckére), nem egy "sima" Python szám — ez azért van, mert a PyTorch mindig tenzorokkal dolgozik, hogy a GPU-gyorsítás és az automatikus deriválás lehetősége mindvégig megmaradjon. Az .item() metódus "kicsomagolja" a tenzorból az egyetlen, benne lévő számot, "sima" Python float formátumba, hogy kényelmesen ki tudd írni vagy tovább tudd használni "hétköznapi" Python-kódban.
- Futtasd le a fenti kódot, és figyeld a kiírt hiba értékeket (Korszak 0, 100, 200, ...) — csökken a hiba a korszakok növekedésével? Ha igen, ez azt jelenti, a modell tényleg tanul.
- Próbáld meg megváltoztatni a tanulási rátát (lr) egy sokkal nagyobb értékre (pl. lr=0.1) — mi történik a hibával? (Segítség: valószínűleg "felrobban" — a hiba hatalmasra nő, vagy "nan" lesz — ez a "túllövés" jelensége, amiről a széljegyzetben olvastál.)
- Új gyakorlat: növeld a rejtett réteg méretét nn.Linear(1, 8)-ról nn.Linear(1, 32)-re (és a második réteget is: nn.Linear(32, 1)-re) — fusson-e le hiba nélkül? Gondolkodj el rajta: ez a "32" szám mit jelent a háló "kapacitása" szempontjából — vajon egy nagyobb szám mindig jobb modellt eredményez?
Források és további olvasnivaló
A lecke témájának hivatalos dokumentációi és alapvető cikkei:
• PyTorch — alapok (hivatalos bevezető) — pytorch.org